注解内容取自视觉SLAM实践第十四版前3讲,涉及部分第4、5讲的内容,其中第5讲涉及内参和外参两个概念。
机器人部分
1、我们先从书上的引例导入我们的注解
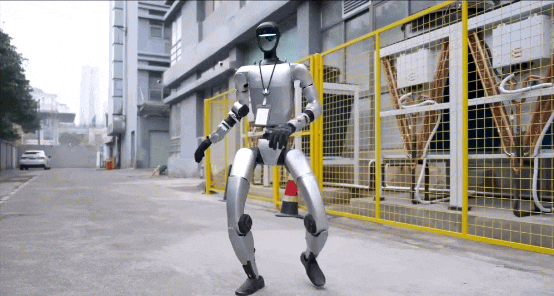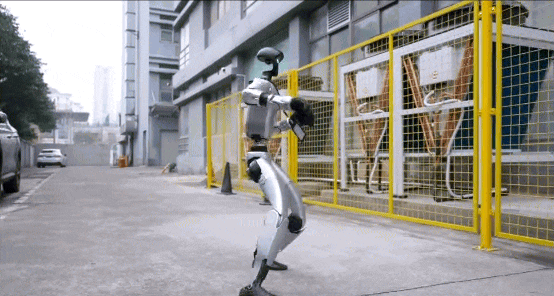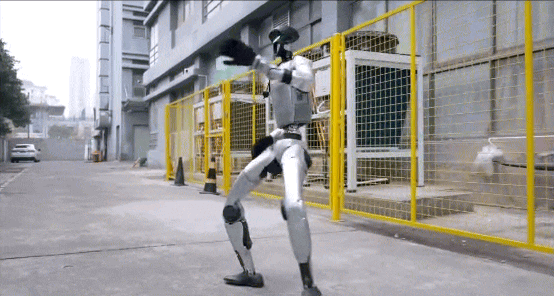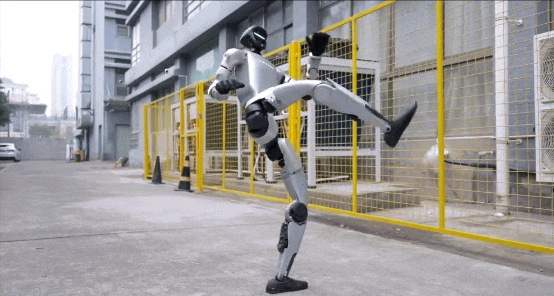
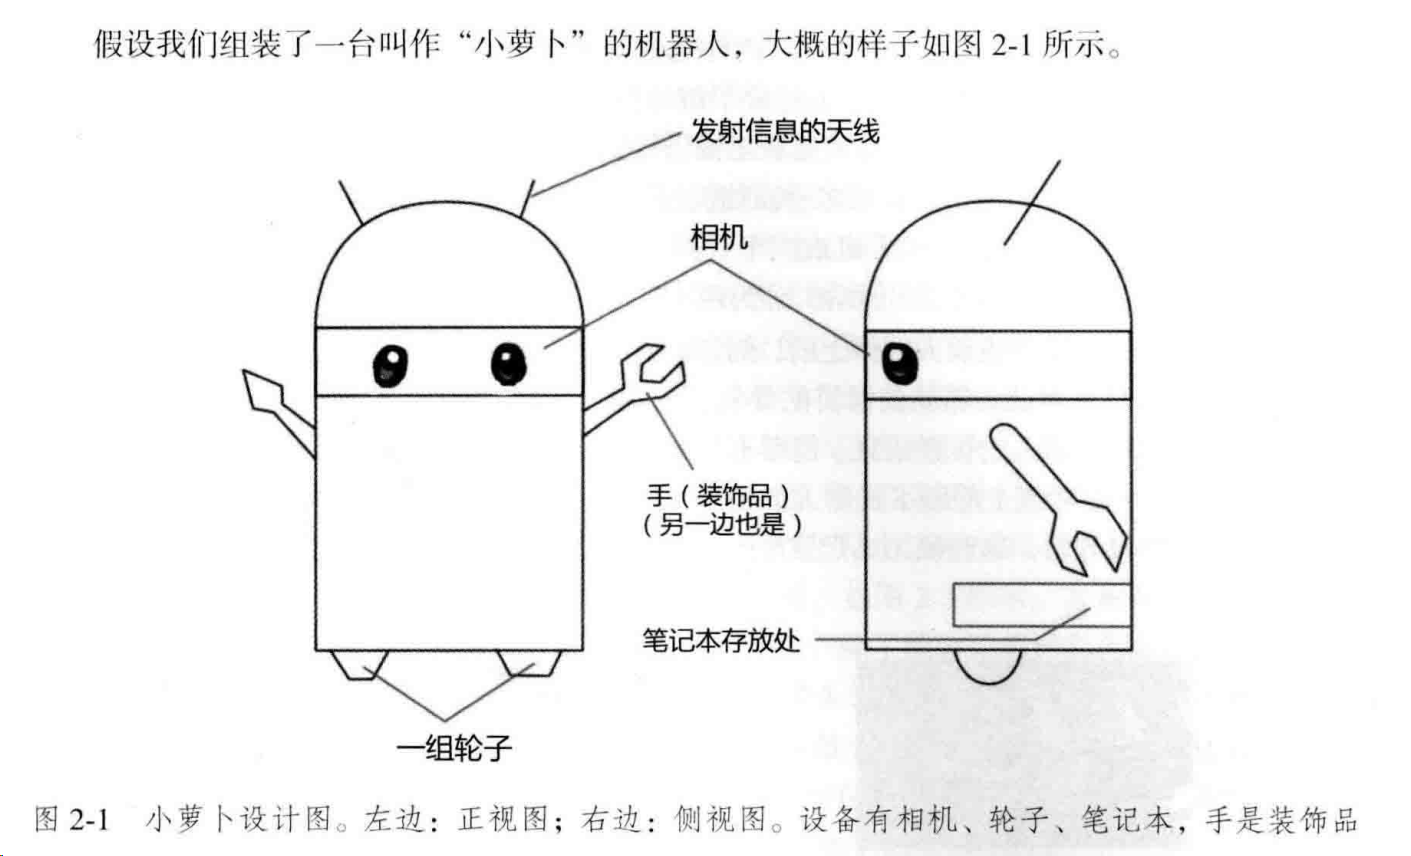
这是当下最火的机器人模型,他的任何一个肢体动作都由各个细小的关节之间的相互协调搭配来完成。机器人通过仿生学原理制成,我们很容易理解的是,机器人的每个动作都是通过各个小关节的一定角度旋转和移动来构成的,每个动作又共同构成了完整的”肢体语言”。
那么我们可以思考一个常常被感性认识占据而从未理性思考过的问题,作为人类,我们无需得到外部指令,只需要主观发出运动的指令,就可以驱使我们的肢体发出”旋转”和”平移”的动作。假如说我告诉你,你让你的胳膊往左移动,你可以不假思索地完成这个动作,那么如果我让你将你的胳膊向左移动5cm呢?你是否能否准确无误地移动出5cm,这显然是不太容易实现的。但是我们研究机器人的目的之一就是希望他按照我们的要求来完成一些事情,包括一些难以实现的要求。我们做不到精确地将自己的胳膊移动5cm,但是我们却希望机器人可以精确地移动出来。
那么,没有人类智慧的机器人,如何按照我们的要求在”精确”这个事情上做好?
我们需要具备一个视角,想象一下机器人的每一个能够活动的部位或关节都是一个坐标系,当前关节只能在限定的坐标系中运动,由于活动一般是无法过于超脱坐标系的,也就是说关节的活动轨迹就是某个函数,在该坐标系中存在一个定义域和值域。这样我们就将具体的运动问题抽象为数学问题了。通过对机器人下达指令,比如在xyz坐标系分别移动多少,机器人就可以相应精确地完成我们下达的指令。
相机部分
说完了机器人的部分,我们仍然需要介绍一个日常用品之一———相机。我们都有过拍照的经验,通过成像技术将我们所处的三维世界中的内容保存在手机中。这里同样存在一个我们常常忽略用理性去思考的过程:我们所处的是三维世界,相机是如何将三维世界的内容转换成二维相片的呢?
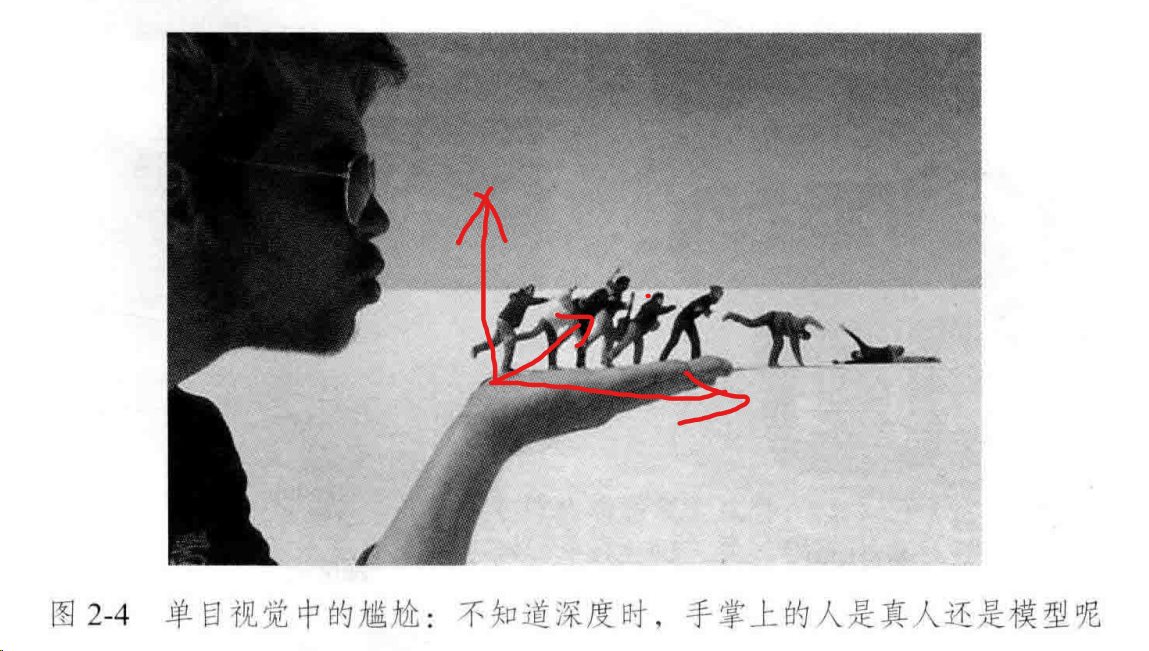
显而易见,在转换的过程中,我们丢失了一个维度———“深度”,根据下图,我们代入观察者的视角就可以很轻松地发现,在相机成像的过程中,这些距离观察者远近不一的人被叠放到了同一平面上。由于我们人类平时已经见过足够多的自然事物,所以我们天然对事物有着感性认识,大部分情况下,当我们去看自己所拍出的照片时可以一眼看出图片上事物哪些离我们远哪些离我们近。然而我们如何让相机同样具备这种能力,并且在这个能力基础上拓展出能够直接计算出深度数值的能力。
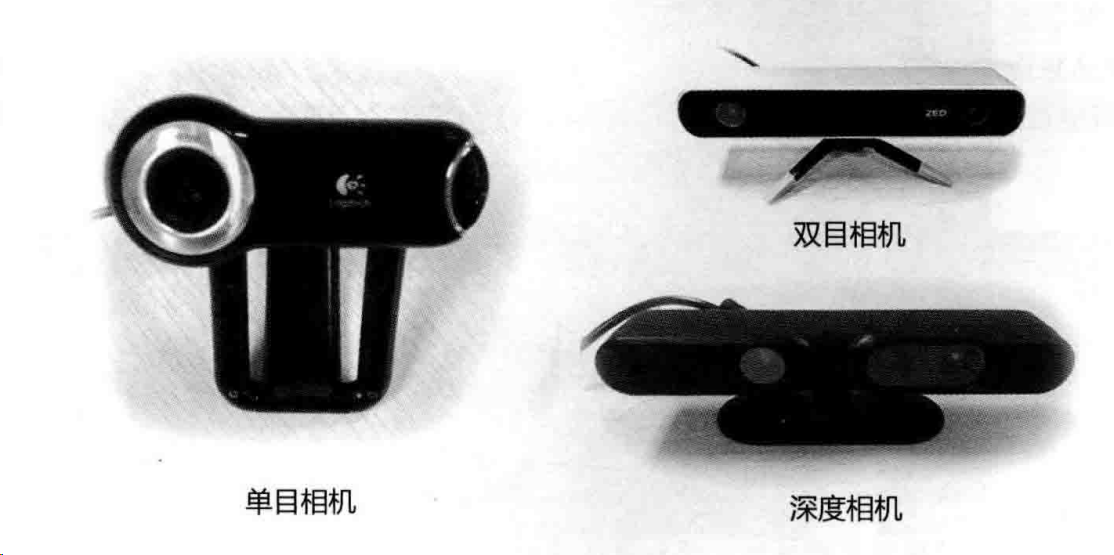
需要注意的是,如今我们每个人的手机基本都配备了三个摄像头、甚至四个摄像头。但最开始的时候,我们的相机通常只有一个摄像头,这里我们称为单目相机,这种相机能够承担简单的成像功能。但正如我们之前所讨论的那样,它在成像的过程中一定会损失一个维度,为了解决这个问题,让我们可以保留在摄影过程中对景物”深度”的拍摄,我们现在多采用两个及以上的摄像头,也即多目相机,分担不同的功能,以实现保留3D效果的目的,更有专门的深度相机来专门承担保留深度维度的功能。
上面提到,每个机器人的关节有一个独立的坐标系,承担各自的运动任务,但是我们在coding的过程中不可能对每一个坐标系都单独进行转换来得到我们所需要的东西,那么我们就需要一个前置自动化任务————将这些独立的坐标系统一到一个坐标系中。世界坐标系(大地坐标系)就可以很好的承担这一功能。
为了实现这个功能,SLAM十四讲中给我们提供了现成的方法:欧式变换(还包括仿射变换等)几种变换没有思维上的差异,只是每个变换所用的矩阵不同。
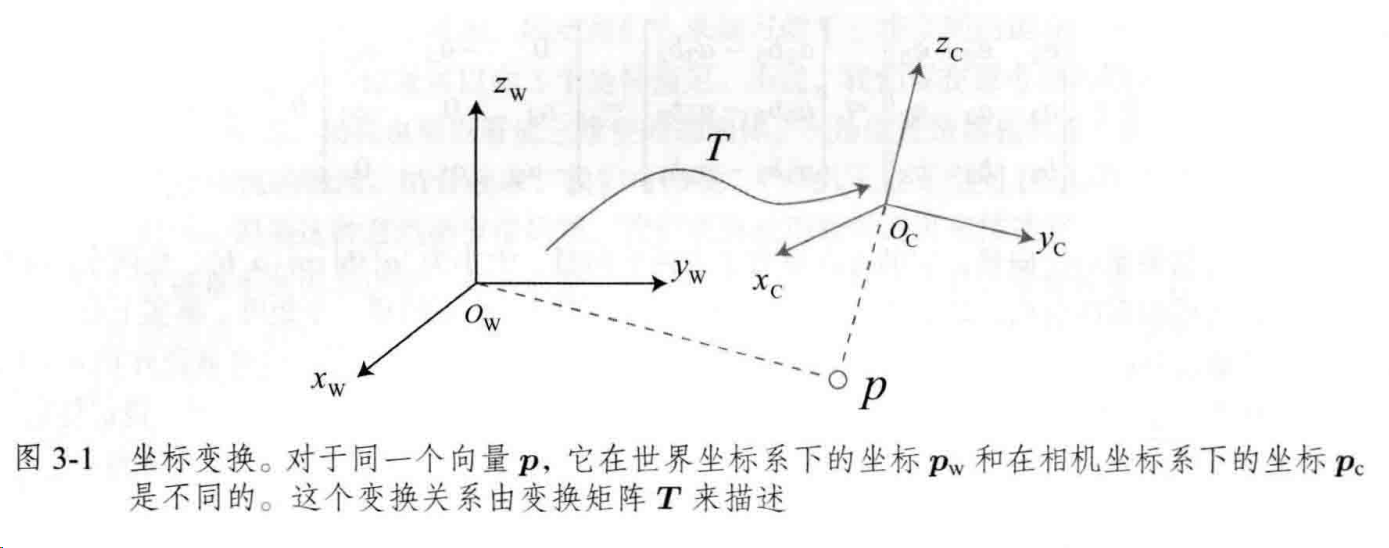
通过坐标变换,我们可以实现各个坐标轴的统一
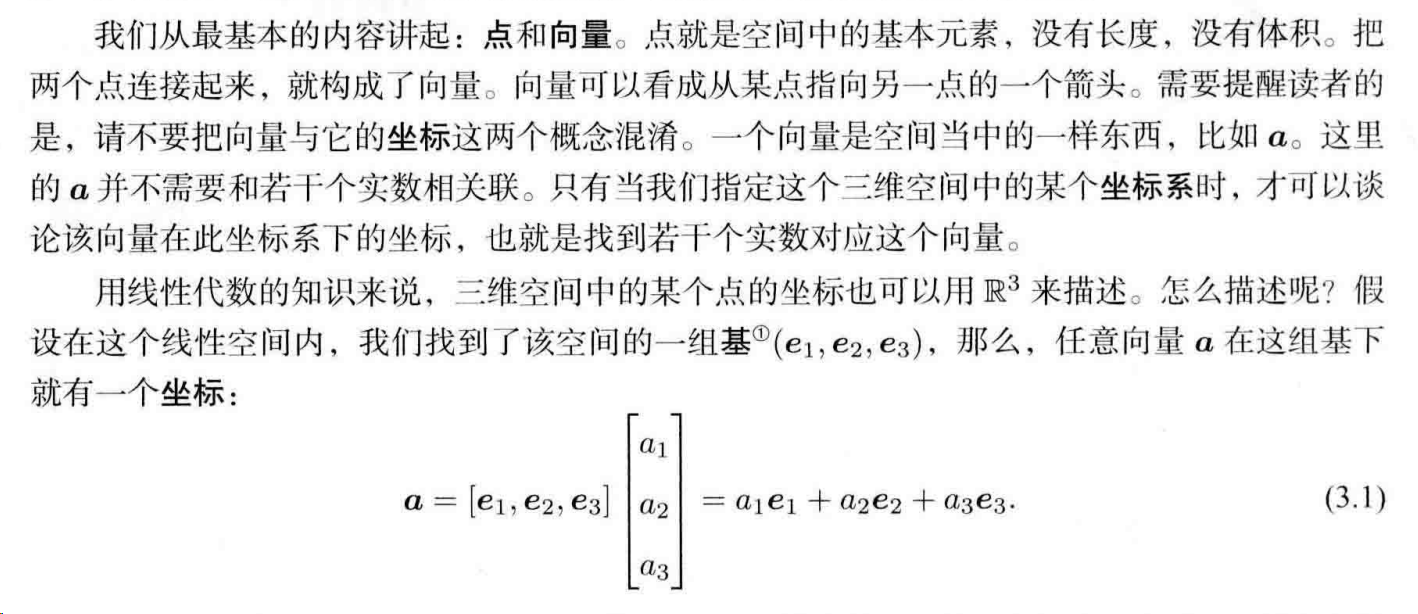
我们从上述式子可以看出,一个空间中的向量是由一个向量基和三个方向上的长度所构成的,基决定了向量的方向。那么我们如果需要让一个向量转化为另一个向量,由于转换前后只是改变了参考系,而他们本身没有改变,所以就会有如下的过程。
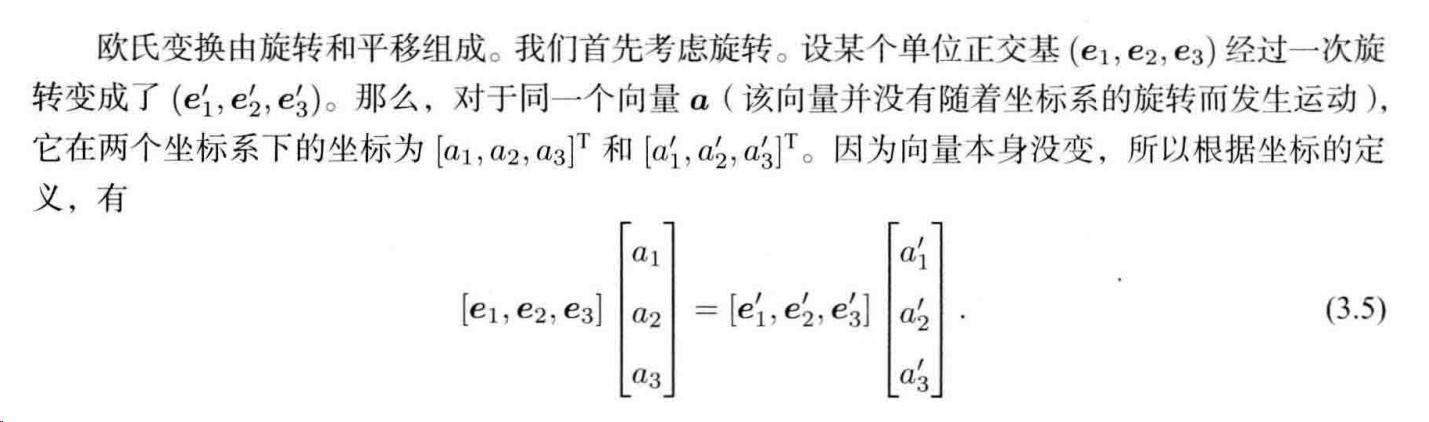
为了便于我们观察,我们对这个式子进行运算
由于左边成为了单位矩阵,所以可以得到:
把中间的矩阵拿出来记为 ,可以得到 ,实际来说,往往也会加一个 ,所以一个标准的表达式就出现了
其中, 称为平移向量。相比于旋转,平移部分只需把平移向量加到旋转之后的坐标上,非常简单。通过上式,我们用一个旋转矩阵 和一个平移向量 完整地描述了一个欧氏空间的坐标变换关系。实际当中,我们会定义坐标系1、坐标系2,那么向量 在两个坐标系下的坐标为 ,
它们之间的关系应该是:
我们在上面完整地表达了欧氏空间的旋转与平移,不过还存在一个小问题:这里的变换关系不是一个线性关系。假设我们进行了两次变换: 和:
那么,从 到 的变换为
但是这样就太麻烦了, 我们决定以线性代数的方式优雅地解决这个式子,
左上角为旋转矩阵,右侧为平移向量,左下角为 向量,右下角为 。我们只需要记住 的矩阵构成就可以。
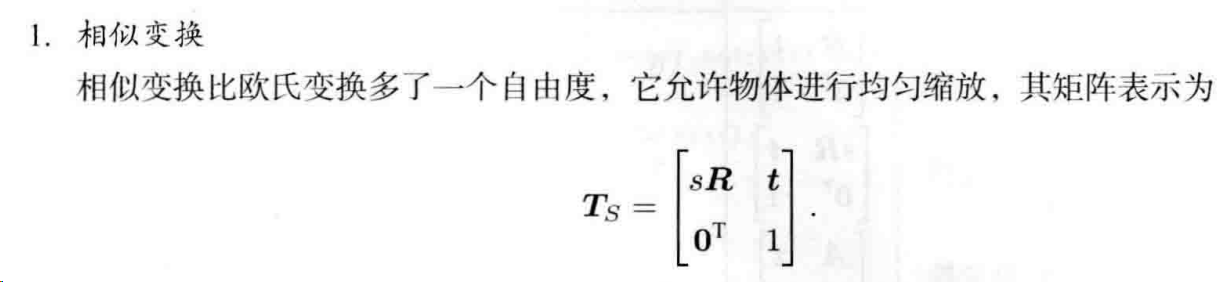
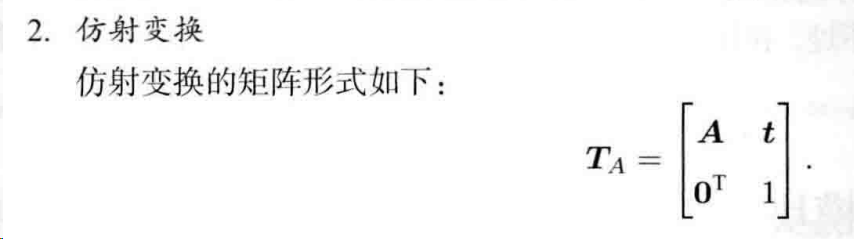
与欧氏变换不同的是,仿射变换只要求 是一个可逆矩阵,而不必是正交矩阵。仿射变换也叫正交投影。经过仿射变换之后,立方体就不再是方的了,但是各个面仍然是平行四边形。
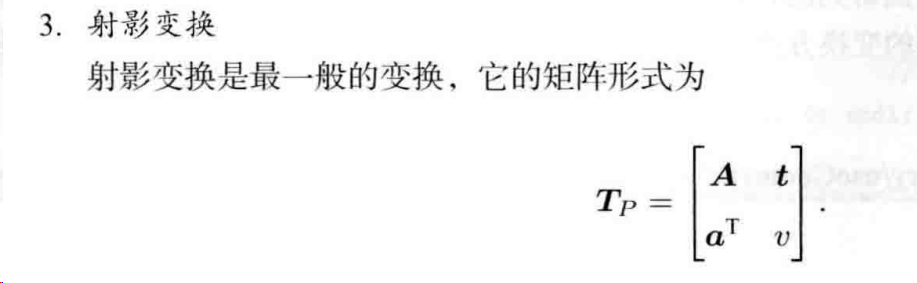
它的左上角为可逆矩阵 ,右上角为平移 ,左下角为缩放 。由于采用了齐次坐标,当 0时,我们可以对整个矩阵除以 得到一个右下角为的矩阵;否则得到右下角为 的矩阵。因此,2D的射影变换一共有 个自由度,3D则共有 个自由度。射影变换是现在讲过的变换中,形式最为一般的。从真实世界到相机照片的变换可以看成一个射影变换。读者可以想象一个原本方形的地板砖,在照片中是什么样子:首先,它不再是方形的。由于近大远小的关系,它甚至不是平行四边形,而是一个不规则的四边形。
从真实世界到相机照片的变换是一个射影变换。如果相机的焦距为无穷远,那么这个变换为仿射变换。不过,在详细讲述相机模型之前,我们只要对它们有个大致的印象即可。
相机模型
在初中物理课堂上,我们可能都见过一个蜡烛投影实验:在一个暗箱的前方放着一支点燃的蜡烛,蜡烛的光透过暗箱上的一个小孔投影在暗箱的后方平面上,并在这个平面上形成一个倒立的蜡烛图像。在这个过程中,小孔模型能够把三维世界中的蜡烛投影到一个二维成像平面。同理,我们可以用这个简单的模型来解释相机的成像过程,如图 5-1 所示。
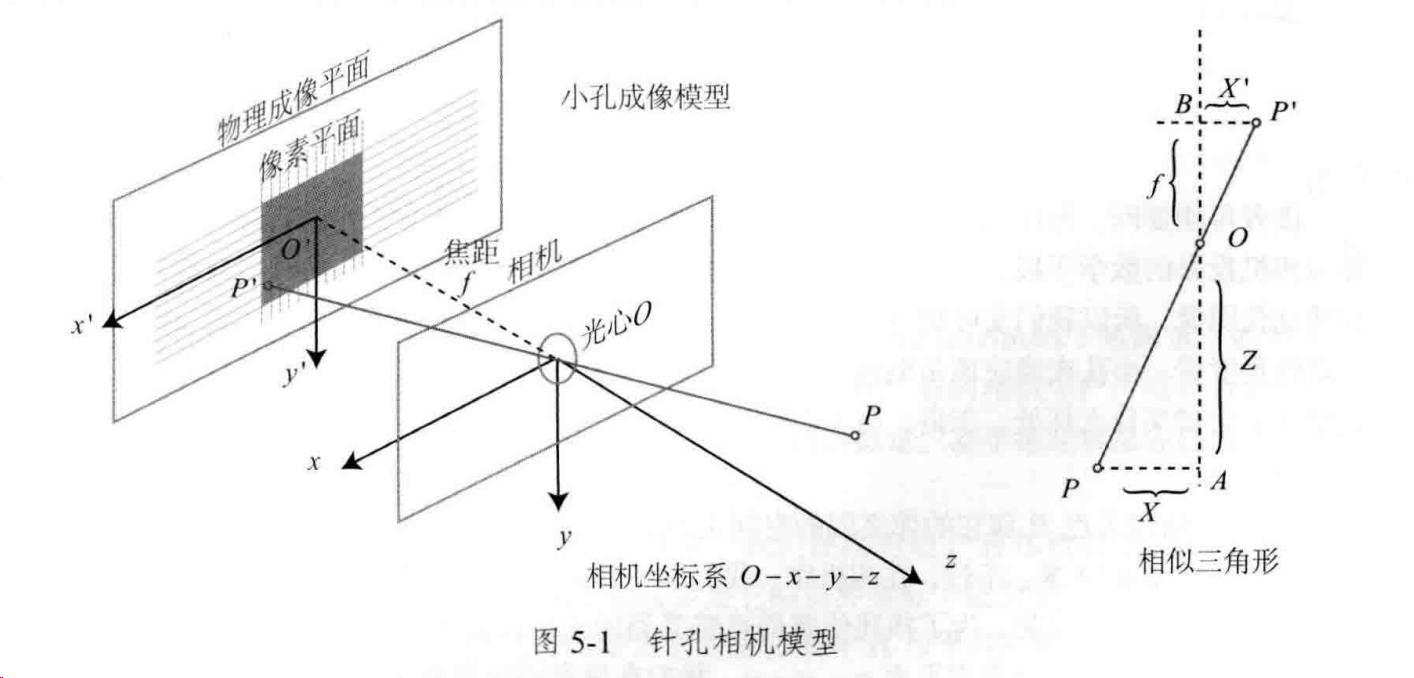
现在对这个简单的针孔模型进行几何建模。设 为相机坐标系,习惯上我们让 轴指向相机前方, 轴向右, 轴向下(此图我们应该站在左侧看右侧)。 为摄像机的光心,也是针孔模型中的针孔。现实世界的空间点 ,经过小孔 投影之后,落在物理成像平面 上,成像点为 。设 的坐标为 , 为 ,并且设物理成像平面到小孔的距离为 (焦距)。那么,根据三角形相似关系,有:
其中负号表示成的像是倒立的。不过,实际相机得到的图像并不是倒像(否则相机的使用会非常不方便)。为了让模型更符合实际,我们可以等价地把成像平面对称地放到相机前方,和三维空间点一起放在摄像机坐标系的同一侧,如图 5-2 所示。这样做可以把公式中的负号去掉,使式子更加简洁:
把 放到等式左侧,整理得
该式描述了点 和它的像之间的空间关系,这里所有点的单位都可理解成米,比如焦距是 米, 是 米。不过,在相机中,我们最终获得的是一个个的像素,这还需要在成像平面上对像进行采样和量化。为了描述传感器将感受到的光线转换成图像像素的过程,我们设在物理成像平面上固定着一个像素平面 。我们在像素平面得到了 的像素坐标:
像素坐标系通常的定义方式是:原点 位于图像的左上角, 轴向右与 轴平行, 轴向下与 轴平行。像素坐标系与成像平面之间,相差了一个缩放和一个原点的平移。我们设像素坐标在 轴上缩放了 倍,在 轴上缩放了 倍。同时,原点平移了 。那么, 的坐标与 的关系为:
代入式子并把合并成,把合并成,得
其中,的单位为米,,的单位为像素/米,所以,和,的单位为像素。把该式写成矩阵形式会更加简洁,不过左侧需要用到齐次坐标,右侧则是非齐次坐标:
也就是
该式中,我们把中间的量组成的矩阵称为相机的内参数(Camera Intrinsics)矩阵 。通常认为,相机的内参在出厂之后是固定的,不会在使用过程中发生变化。有的相机生产厂商会告诉你相机的内参,而有时需要你自己确定相机的内参,也就是所谓的标定。
有内参就会有外参,在上式中,我们使用的是 在相机坐标系下的坐标,但实际上由于相机在运动,所以 的相机坐标应该是它的世界坐标(记为 )根据相机的当前位姿变换到相机坐标系下的结果。相机的位姿由它的旋转矩阵 和平移向量 来描述。那么有
注意后一个式子隐含了一次齐次坐标到非齐次坐标的转换。它描述了 的世界坐标到像素坐标的投影关系。其中,相机的位姿 和 又称为相机的外参数(Camera Extrinsics)②。相比于不变的内参,外参会随着相机运动发生改变,也是SLAM中待估计的目标,代表着机器人的轨迹。投影过程还可以从另一个角度来看。式子表明,我们可以把一个世界坐标点先转换到相机坐标系,再除掉它最后一维的数值(即该点距离相机成像平面的深度),这相当于把最后一维进行归一化处理,得到点 在相机归一化平面上的投影:
归一化坐标可看成相机前方Z=1处的平面上的一个点,这个 平面也称为归一化平面。归一化坐标再左乘内参就得到了像素坐标,所以我们可以把像素坐标 看成对归一化平面上的点进行量化测量的结果。从这个模型中也可以看出,如果对相机坐标同时乘以任意非零常数,归一化坐标都是一样的,这说明点的深度在投影过程中被丢失了,所以单目视觉中没法得到像素点的深度值。